驱动之路#68:一文看懂 PCI/PCIe 设备访问流程
1153 #智讯达人 标签:题图:特斯拉在美国推出 Cybercab 出租车。根据马斯克的说法,特斯拉将来的主营业务,不再是生产汽车,而是经营无人驾驶出租车。
本合集分享的是,我当初学习Linux驱动的来时路——《《驱动之路》开篇:自序&前言》。
正文
前面几篇文章,我们已经聊了 PCIe 的不少基础概念。
比如:
PCIe是什么;PCI 和 PCIe 有什么区别;RC 和 EP 是什么;PCIe 为什么和地址空间有关;PCIe 是如何传输数据的;RK3576 PCIe 驱动大概长什么样。
但真正写驱动或者调试 PCIe 设备时,还会遇到一个更实际的问题:
软件到底是怎么找到 PCI/PCIe 设备的?找到之后,又是怎么和这个设备通信的?
这个问题刚开始看会有点绕。
因为 PCI/PCIe 设备不像 I2C 那样直接给一个设备地址,也不像 SPI 那样拉低 CS 就开始通信。
PCI/PCIe 有一套比较完整的流程:
设备枚举;资源分配;驱动匹配;地址映射;中断配置;DMA 传输。
这篇就按一条主线,把 PCI/PCIe 设备访问流程捋一遍。
1. 先说结论
PCI/PCIe 设备访问流程,可以简单概括成 4 步:
识别设备;分配资源;映射地址;数据交互。
再展开一点就是:
系统先枚举 PCI/PCIe 总线,发现设备;PCI core 给设备分配 BAR、中断等资源;设备驱动匹配成功后,映射 BAR 空间;驱动通过 MMIO 配置设备,通过 DMA 搬运大块数据;设备通过中断通知 CPU。
如果用“找人办事”来类比:
枚举设备:先确认对方是谁;资源分配:给对方安排办公位置和联系方式;地址映射:拿到能访问它的入口;数据交互:正式下发任务、收结果。
理解了这条线,后面看lspci、BAR、DMA、中断、驱动 probe,就没那么乱了。
2.PCIe 设备访问流程
第 1 步:设备识别
系统要访问 PCI/PCIe 设备,第一步是先发现它。
在 PCIe 体系里,这个过程通常叫:枚举。
在嵌入式平台中,一般是 SoC 的 PCIe 控制器工作在 RC 模式。
比如:
RK3576/ RK3588:RCPCIe WiFi / NVMe SSD / 网卡:EP
系统启动时,PCIe Host Controller 驱动先初始化 RC,建立 PCIe Link。
然后 Linux PCI 子系统会扫描总线,通过配置空间访问,读取 EP 的信息。
比如:
Vendor ID;Device ID;ClassCode;HeaderType;BAR;Capability;MSI / MSI-XCapability。
这些信息可以理解成设备的“身份证”和“能力表”。
如果设备枚举成功,用命令可以看到:
lspci
比如可能看到:
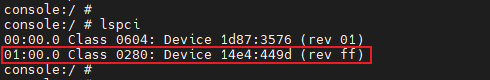
其中类似:
14e4:449d
这种就是 Vendor ID 和 Device ID。
它们后面会用于驱动匹配。
这里要注意一个细节。
不是某个 WiFi 驱动一上来就自己去扫 PCIe 总线。
更准确的流程是:
PCIeHost Controller 驱动初始化;Linux PCI core 枚举 PCI/PCIe 设备;系统创建 pci_dev;PCI 设备驱动根据 ID 表匹配设备;匹配成功后调用驱动 probe。
也就是说:先由 PCI core 发现设备,再由具体设备驱动接管设备。
比如 PCIe WiFi 驱动里通常会有一个 ID 表:
当 PCI core 枚举到14e4:449d这个设备后,就会尝试匹配对应驱动。
匹配成功后,才会调用这个驱动的probe()。
所以如果lspci都看不到设备,就不要急着改 WiFi 驱动。
这时设备驱动可能根本还没机会 probe。
第 2 步:资源配置
设备识别出来后,系统还要给它分配资源。
PCI/PCIe 设备通常需要几类资源:
BAR 地址空间;中断资源;DMA 能力;总线号 / 设备号 / 功能号;电源管理能力;MSI / MSI-X能力。
其中最重要的是 BAR。
BAR 全称是Base Address Register。
它位于 PCI 配置空间中。
设备通过 BAR 告诉系统:我需要一段 MMIO 或 I/O 地址空间,主机可以通过这段地址访问我的寄存器或内部资源。
系统枚举设备时,会读取 BAR,判断这个设备需要多大资源。
然后 PCI core 会从 PCIe Host Bridge 提供的资源窗口里,给它分配合适的地址范围。
比如在lspci -vv里可能看到:
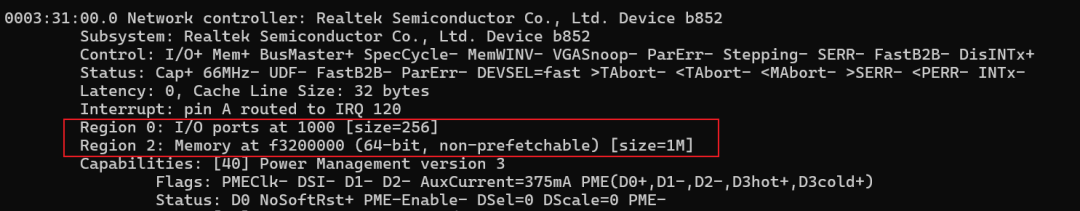
这里的 Region 就对应设备的 BAR 资源。
资源配置主要由 PCI core 完成。
这里也容易误解。
不是普通设备驱动自己从全局资源池里手动给设备分配 BAR 地址。
更准确地说:
PCIcore 负责枚举设备和分配资源;设备驱动负责启用设备、申请资源、映射资源、初始化设备。
驱动里常见流程可能是:
ret= pci_enable_device(pdev);ret= pci_request_regions(pdev,"xxx");base= pci_iomap(pdev,0,0);
大概意思是:
pci_enable_device() 启用 PCI 设备。pci_request_regions() 申请使用 BAR 对应资源,避免和其他驱动冲突。pci_iomap() 把 BAR 映射成 CPU 可访问的内核虚拟地址。
所以资源分配和驱动使用资源,是两个阶段。
这个区别要分清楚。
第 3 步:地址映射
资源分配完成后,驱动还不能直接拿数字地址乱读写。
在 Linux 内核里,驱动需要把设备 BAR 资源映射成内核可访问的虚拟地址。
常见做法是:
void__iomem *base;base= pci_iomap(pdev,0,0);
或者先拿 BAR 信息:
resource_size_tstart;resource_size_tlen;start= pci_resource_start(pdev,0);len= pci_resource_len(pdev,0);
再映射。
映射成功后,驱动就可以通过:
readl(base+ offset);writel(val,base+ offset);
访问设备寄存器。
从驱动视角看,这像是在访问一段内存。
但硬件背后发生的是:
CPU访问 MMIO 虚拟地址 ↓MMU 转成 CPU 物理地址 ↓PCIe Host Controller 识别这是 PCIe outbound 访问 ↓转换成 PCIe Bus 地址 ↓生成 PCIe TLP ↓发送到对应 EP 的 BAR 空间 ↓EP 响应读写
所以 PCIe 驱动访问 BAR,本质上是通过内存映射 I/O 访问 PCIe 设备。
一句话:BAR 给设备分配地址,ioremap / pci_iomap 给驱动一个可访问入口。
第 4 步:数据交互
地址映射完成后,驱动就可以和设备交互了。
PCI/PCIe 设备常见交互方式主要有两类:
MMIO;DMA。
(1)MMIO:用于配置设备和访问寄存器
MMIO 是 Memory-Mapped I/O。
也就是把设备寄存器映射到内存地址空间里,驱动通过readl()/writel()访问。
常见用途:
读取设备状态;配置控制寄存器;启动 DMA;设置队列地址;写 doorbell;清中断状态;读取错误信息。
比如 NVMe 驱动会通过 MMIO 访问控制器寄存器、doorbell 等。
网卡驱动也会通过 MMIO 配置描述符队列、中断、中断屏蔽等。
MMIO 的特点是:
简单直接;适合寄存器访问;CPU 参与;不适合大块数据搬运。
所以不要把大量数据都靠readl()/writel()搬。
那样效率会很低。
(2)DMA:用于大块高速数据传输
PCIe 设备真正高性能的关键,通常是 DMA。
比如:
NVMeSSD 读写数据;网卡收发网络包;采集卡搬运图像;AI 加速卡搬运输入输出 buffer。
这些都不可能靠 CPU 一个字节一个字节读写 BAR。
更常见的流程是:
驱动在内存中准备 buffer 或描述符;通过 DMA mapping API 得到设备可访问的 DMA 地址;把 DMA 地址、长度、方向写入设备寄存器或队列;设备通过 PCIe 主动读写主机内存;传输完成后,设备通过中断通知 CPU。
注意这里有一个关键点:驱动不能简单把 CPU 物理地址直接丢给设备。
在 Linux 里,尤其是有 IOMMU、cache、一致性要求的平台上,通常要使用 DMA API。
比如:
dma_addr_tdma;dma= dma_map_single(dev, buf, len, DMA_TO_DEVICE);
或者分配一致性 DMA 内存:
cpu_addr= dma_alloc_coherent(dev, size, &dma_handle, GFP_KERNEL);
这里的dma_handle才是设备侧用来访问内存的 DMA 地址。
所以更准确的说法是:
CPU用虚拟地址访问内存;设备用 DMA 地址访问内存;中间可能经过 IOMMU 或 DMA 地址转换。
这点在 PCIe 驱动里非常重要。
3. 中断:设备如何通知 CPU?
设备完成任务后,不能一直等 CPU 轮询。
所以 PCI/PCIe 设备通常会用中断通知 CPU。
常见中断方式有:
传统 INTx;MSI;MSI-X。
现代 PCIe 设备大量使用 MSI / MSI-X。
比如:
NVMe完成一个 IO;网卡收到一批数据;DMA 传输完成;设备发生错误;
设备会向主机发送中断消息,CPU 进入中断处理函数,驱动再处理后续逻辑。
所以完整交互一般是:
驱动通过 MMIO 配置设备;设备通过 DMA 搬数据;设备通过 MSI/MSI-X通知完成;驱动在中断里处理结果。
这才是 PCIe 高速设备比较典型的工作模式。
4. 访问流程总览
可以把 PCI/PCIe 设备访问流程总结成下面这条线:
PCIe Link 建立 ↓PCI core 枚举设备 ↓读取配置空间 ↓识别 Vendor ID / Device ID / ClassCode ↓分配 BAR / IRQ 等资源 ↓匹配 pci_driver ↓调用驱动 probe ↓pci_enable_device ↓pci_request_regions ↓pci_iomap / ioremap BAR ↓配置 DMA / MSI / 队列 ↓MMIO 控制设备 ↓DMA 搬运数据 ↓中断通知完成
这个流程不一定每个驱动都完全一样,但主线基本类似。
5. 总结
PCI/PCIe 设备访问流程,本质上可以概括为:
先枚举发现设备;再分配 BAR 和中断等资源;驱动匹配后映射 BAR;通过 MMIO 控制设备;通过 DMA 搬运大块数据;通过中断通知 CPU。
一句话理解:MMIO 负责“下命令”,DMA 负责“搬数据”,中断负责“通知完成”。
再把完整流程压缩一下:
识别设备:Vendor ID / Device ID / ClassCode;配置资源:BAR / IRQ / MSI / DMA 能力;地址映射:pci_iomap / ioremap;数据交互:MMIO + DMA + Interrupt。
对嵌入式 Linux / BSP 开发来说,理解这条链路很重要。
因为 PCIe 问题通常不是单点问题,而是分阶段失败。
看不到设备,先查 Link;能看到设备,查驱动匹配;probe 失败,查 BAR / DMA / MSI;传输异常,查 DMA / 中断 / AER / 链路状态。
把流程拆清楚,PCIe 调试就不会那么玄学。
(完)
欢迎关注,每周更新!
审核编辑 黄宇
 智讯达人